各位漫剧大佬、潜力股们
Fish Audio应该都不陌生吧?
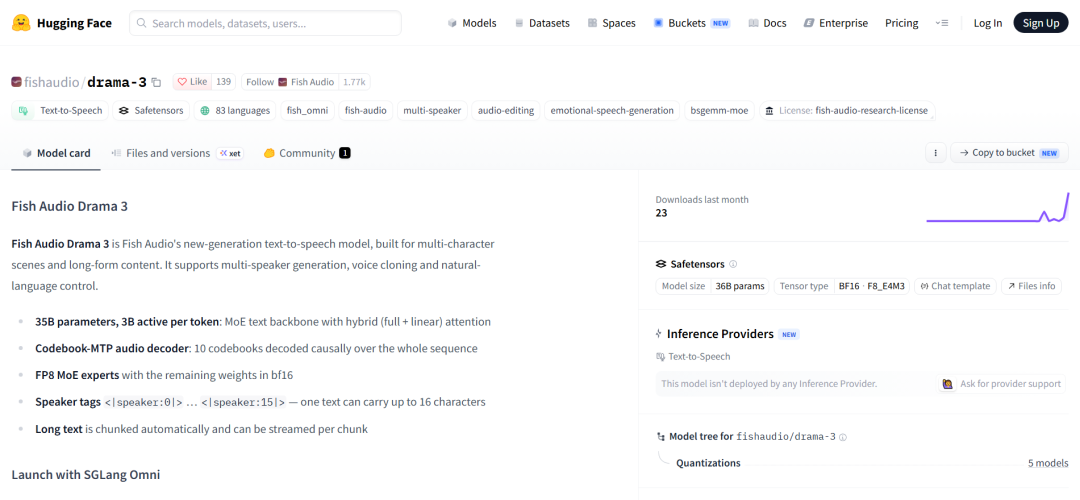
他家今天正式发布了全新的文本转语音(TTS)模型 Drama 3
官方将其定位为目前情感最丰富、最可控的语音模型,并且直接在 Hugging Face 上开源了模型权重(fishaudio/drama-3)
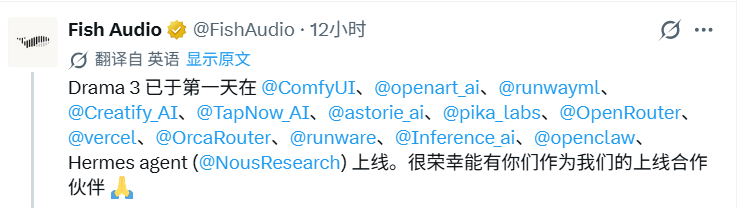
且目前Drama 3已经在官网、API 以及 ComfyUI 等多个主流创作者工具中同步上线,想上手的已经可以直接用了
核心能力升级:把声音控制细化到了单个词
过去大家用 TTS 工具配音,最烦的就是一句话里有八成是满意的,偏偏有一个词重音不对、念错读音或情绪没到位
为了改这一个词,只能整句推倒重抽,真就挺烦的
Drama 3这次把优化重心全放在了可控性与可编辑性上,经过一番攻关克难,终于带来了六项非常牛的能力
OK,说回它那六项非常牛的能力
1,自然语言直接导戏
大概就是说,你可以直接用普通文字描述你想要的语气、情绪和说话节奏,不需要死记硬背固定的代码标签
而且控制指令支持用与台词文本不同的语言来写,比如用中文指令指导英文台词的语气,这个就很牛了
2,一句话中途变调
支持在同一句话的中间直接改变语气、声音或情绪状态,非常适合演出来回拉扯的心理戏或情绪反转
有点视频模型实时生成的意思,随时可干预调整
3,单词级精准控制
通过 <whisper>(耳语)、<emphasis>(强调)这类成对标签,可以只改变某一个特定词语的发音方式,不用整句重新生成
也就是说,本来角色是带着哭腔的,突然就能话锋一转,直接蔑视了😂
4,气口与停顿随手插
在台词需要的地方,可以直接插入 [sigh](叹气)、[laugh](笑声)、[pause](停顿)等标记,把角色的呼吸感和生活感直接做进音轨里
声明的对比视频里就有,仔细听
5,单次搞定多角色对话
一次生成就能同时处理多个角色的来回对白,不同角色的声音依然能保持清晰区分,省去了切成十几条碎音频再去剪辑轨硬拼的麻烦
这个就真的是很省事了
6,局部编辑(Audio Inpainting)
如果整段配音都很好,只有某一个词读错了或者临时想改词,可以只重新生成那一个词或小片段,无需整段推倒重来
周围的声音质感、说话节奏和情绪完全保持不变
这就有点类似于现在的视频模型局部片段修改的意思了
极大的提高了修改瑕疵的便利性,压低了制作的成本
在规格上,Drama 3采用的是35B MoE架构
虽然总参数量达到了350 亿,但在实际推理时每个token仅激活约3B参数,兼顾了声音细节与推理速度
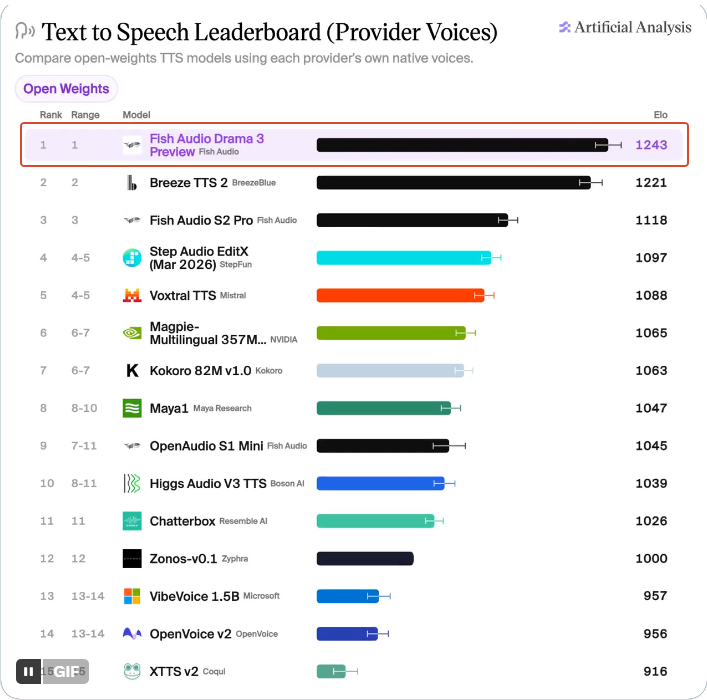
模型一共支持83种语言,在权威评测机构Artificial Analysis的测试中,Drama 3在开源权重 TTS 模型里排名领先
硬件与部署方面,本地推理目前主要支持NVIDIA GPU,推理框架 SGLang-Omni已经在发布当天提供了Day-0原生支持
商用权限方面,官方的规定是:年收入低于 50 万美元的团队或个人,可以直接免费商用;如果团队年收入超过 50 万美元,或者打算拿它对外提供商业TTS / API服务,则需要联系官方另行获取商业授权
等同于随便用
虽然现在的视频模型大多已经做到了音画同出,但TTS模型依然是有巨大市场的,比如有声书,比如多语言出海内容
如果你也想玩,可以去这里试用,现在官方是免费提供试用的
https://fish.audio/drama-3/?utm_source=x&utm_medium=influencer&utm_campaign=drama3-atomik&utm_content=creator
如果你认为自己的电脑带得动它的话,可以去这里下载
https://huggingface.co/fishaudio/drama-3